Quels générateurs d'applications IA créent un vrai backend — et qu'est-ce qui compte comme « vrai » ?
Réponse courte : un vrai backend, ce sont des données PostgreSQL persistantes, une authentification côté serveur et des API REST qui font respecter les règles sur le serveur — pas un beau frontend React où le formulaire de connexion n'authentifie personne et où les graphiques du dashboard rendent du JSON codé en dur. La plupart des générateurs d'applications IA produisent la deuxième chose. VULK (notre produit — transparence ci-dessous) génère et déploie la première : quand ton prompt décrit des comptes, des données sauvegardées ou des rôles d'admin, il provisionne automatiquement un vrai backend — schéma PostgreSQL, endpoints CRUD, auth JWT avec rôles — aux côtés du frontend, câblé et déployé. Lovable et Bolt prennent une route différente et légitime : ils délèguent le backend à Supabase, ce qui fonctionne bien mais signifie opérer une deuxième plateforme. Les outils frontend-first te laissent construire toi-même les 60 % difficiles.
La demande n'est pas un cas limite : 62 % de toutes les applis générées sur VULK incluent un schéma SQL (données de la plateforme VULK, juillet 2026, sur 11 355 applis générées) — la plupart des gens qui promptent une « appli » décrivent quelque chose avec des utilisateurs et des données, qu'ils le réalisent ou non. Ce guide couvre tout : les quatre tests d'un vrai backend, le fonctionnement du provisioning automatique, à quoi ressemblent vraiment le schéma et l'auth générés, les patterns de sécurité, le déploiement, six prompts complets à copier-coller, et l'histoire de l'export et de la portabilité, la nôtre incluse. Transparence : VULK est notre produit. Mis à jour le 17 juillet 2026.
Tableau comparatif : comment les builders IA gèrent le backend
| Outil | Approche backend | Base de données | Auth | Portabilité du backend | Prix d'entrée |
|---|---|---|---|---|---|
| VULK | Généré + déployé (moteur d'API) | PostgreSQL par projet | Générée (JWT, rôles, password_hash) |
Export schéma (SQL) + données (CSV) | 19,99 $/mois |
| Lovable | Délégué à Supabase | Supabase Postgres | Supabase Auth | Ton projet Supabase — pg_dump complet | Gratuit (limité) → 25 $/mois |
| Bolt | Délégué à Supabase | Supabase Postgres | Supabase Auth | Ton projet Supabase | Gratuit → 25 $/mois |
| Replit | Écrit par l'agent, n'importe quel stack | PostgreSQL hébergé | Écrite par l'agent ou Replit Auth | Accès complet au code | Gratuit → Core 25 $/mois |
| Databutton | FastAPI généré (Python) | Intégrée + externe | Intégrée | Code visible/exportable | 20 $/mois |
| Base44 | Propriétaire embarqué | Intégrée | Intégrée | Pas d'export du backend | Gratuit (25 crédits) → 20 $/mois |
| v0 | Frontend-first + intégrations | Via add-ons du marketplace | Via add-ons | N/A (assemblé) | Gratuit → 20 $/mois |
Trois architectures se cachent derrière l'étiquette « builder IA full-stack ». Généré (VULK, Databutton) : l'IA écrit ton schéma, tes endpoints et ton auth comme partie de l'appli — le plus intégré, et le code serveur généré est inspectable. Délégué (Lovable, Bolt → Supabase) : l'outil câble ton frontend à un BaaS managé — excellente DX et portabilité des données propre, mais tu opères deux plateformes et hérites de la forme du BaaS. Embarqué (Base44) : zéro configuration, zéro sortie. Aucune n'est fausse ; elles échouent différemment à mesure que tu grandis. Tarifs vérifiés le 17 juillet 2026.
Que manque-t-il vraiment aux applis IA frontend-only ?
Faites passer n'importe quelle démo de « générateur d'applications IA » par quatre tests :
- Persistance : crée des données, redéploie — sont-elles encore là ? Les applis à données factices se réinitialisent. Les applis localStorage prennent les données en otage dans un navigateur.
- Vraie auth : le formulaire de connexion vérifie-t-il les identifiants sur un serveur et émet-il une session ? L'« auth » côté client est de la décoration — n'importe qui ouvre les DevTools et passe à côté.
- Règles imposées côté serveur : l'utilisateur A peut-il récupérer les enregistrements de l'utilisateur B en changeant un ID dans la requête ? Si la validation ne vit que dans React, la réponse est oui.
- Données inspectables : peux-tu exécuter du SQL sur ta propre base ?
Échoue à ces tests et tu as un prototype — réellement utile pour valider une idée, et c'est là que des outils comme v0 brillent. Mais l'écart entre ce prototype et un produit, c'est précisément le backend : comptes, rôles, validation, relations, migrations. C'est la partie qui a historiquement mangé le plus de temps d'ingénierie — et celle dont 62 % des générations VULK finissent par avoir besoin (données de la plateforme VULK, juillet 2026).
Comment VULK provisionne-t-il un backend automatiquement ?
Tu ne dis jamais « ajoute un backend ». La détection lit ton prompt à la recherche de signaux :
- Signaux d'auth — « connexion », « inscription », « comptes utilisateurs », « panneau d'admin », « rôles » : déclenchent le système d'auth.
- Signaux de persistance — « sauvegarder », « stocker », « historique », « enregistrements », « base de données » : déclenchent la génération schéma + CRUD.
- Signaux d'API — « endpoint », « REST », « webhook » : déclenchent la génération de routes.
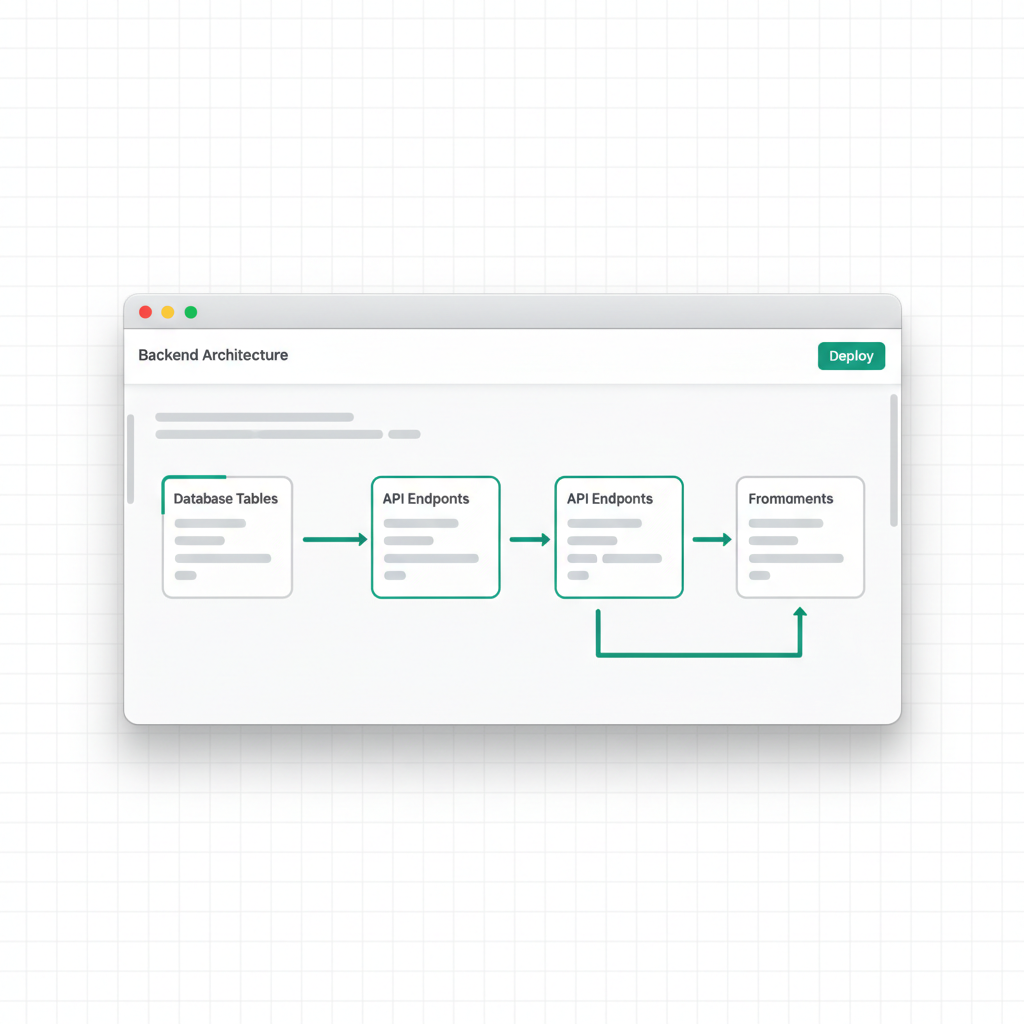
La détection est délibérément conservatrice — une landing page ou un portfolio reste un frontend statique rapide ; un prompt avec « les utilisateurs peuvent publier des annonces et écrire aux vendeurs » reçoit le stack complet. Quand elle se déclenche, une seule génération produit quatre couches coordonnées :
- Schéma PostgreSQL — tables, types, contraintes, clés étrangères, index, dérivés des entités de ton prompt.
- API REST — CRUD complet par entité avec validation, pagination et codes de statut corrects, déployé sur le moteur d'API de VULK.
- Système d'auth — endpoints d'inscription et de connexion, hachage bcrypt des mots de passe, émission de JWT, middleware protégeant les routes privées, vérifications de rôles quand ton prompt en implique.
- Frontend câblé — l'appli React est générée contre cette API : les appels fetch pointent vers de vrais endpoints, les tokens s'attachent aux requêtes, les états de chargement et d'erreur existent. Le formulaire de connexion te connecte vraiment. Cette dernière couche est ce qui sépare « a généré un backend » de « a généré deux moitiés que tu auras le plaisir d'intégrer toi-même ».
L'éditeur te donne ensuite un panneau Backend : parcours tables et lignes, exécute du SQL brut dans un query runner, teste les endpoints avec un testeur d'API et exporte n'importe quelle table en CSV. Tes données ne sont jamais derrière un rideau.
À quoi ressemble le schéma SQL généré ?
La qualité du schéma décide de la qualité de l'application, donc la génération impose les patterns qu'un ingénieur base de données soigneux utiliserait. Pour « un gestionnaire de tâches où les utilisateurs créent des projets et ajoutent des tâches ; les utilisateurs ne voient que leurs propres projets » :
CREATE TABLE users (
  id            SERIAL PRIMARY KEY,
  email         VARCHAR(255) UNIQUE NOT NULL,
  password_hash VARCHAR(255) NOT NULL,
  name          VARCHAR(120) NOT NULL,
  role          VARCHAR(20) NOT NULL DEFAULT 'member',
  created_at    TIMESTAMPTZ NOT NULL DEFAULT now(),
  updated_at    TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE TABLE projects (
  id         SERIAL PRIMARY KEY,
  user_id    INTEGER NOT NULL REFERENCES users(id) ON DELETE CASCADE,
  name       VARCHAR(160) NOT NULL,
  created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
  updated_at TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE TABLE tasks (
  id          SERIAL PRIMARY KEY,
  project_id  INTEGER NOT NULL REFERENCES projects(id) ON DELETE CASCADE,
  title       VARCHAR(200) NOT NULL,
  description TEXT,
  priority    VARCHAR(10) NOT NULL DEFAULT 'medium'
              CHECK (priority IN ('low','medium','high')),
  status      VARCHAR(12) NOT NULL DEFAULT 'open'
              CHECK (status IN ('open','in_progress','done')),
  due_date    DATE,
  created_at  TIMESTAMPTZ NOT NULL DEFAULT now(),
  updated_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE INDEX idx_projects_user_id ON projects(user_id);
CREATE INDEX idx_tasks_project_id ON tasks(project_id);
CREATE INDEX idx_users_email ON users(email);
Les choix délibérés, chacun étant un échec courant du code généré naïf :
password_hash, jamaispassword. Le nom de colonne lui-même rend le stockage en clair impossible à écrire par accident — une règle imposée au niveau du prompt engineering.- Clés étrangères au comportement de suppression intentionnel —
ON DELETE CASCADEquand les enfants ne doivent pas survivre aux parents ;SET NULLquand les orphelins doivent survivre (des produits qui survivent à une catégorie supprimée). - Contraintes CHECK pour les valeurs bornées — un statut de tâche ne peut pas devenir silencieusement
"donee". - Des index qui collent aux patterns de requête — clés étrangères, e-mail de lookup à la connexion, colonnes de tri.
- Des timestamps sur chaque table. Ennuyeux jusqu'à ce qu'on en ait besoin ; ensuite, critiques.
Pourquoi PostgreSQL et pas MongoDB ou Firebase ? Parce que les applis que les gens promptent sont massivement relationnelles — les commandes contiennent des articles, les tâches appartiennent à des projets, les projets appartiennent à des utilisateurs — et les clés étrangères avec contraintes expriment cela avec des garanties d'intégrité que les documents ne peuvent pas offrir. Et parce qu'une dépendance à un BaaS tiers casserait « un prompt, une appli déployée qui marche » avec la création d'un compte sur une deuxième plateforme. Postgres est ce que tu choisirais à la main pour la production — c'est donc ce qui est généré.
Comment fonctionne l'authentification générée ?
Le flux d'auth complet, construit comme il se doit — parce que l'auth est la couche où les raccourcis générés deviennent des brèches :
POST /api/auth/register— valide l'entrée, hache le mot de passe avec bcrypt (jamais en clair, jamais réversible), le stocke danspassword_hash, renvoie un JWT.POST /api/auth/login— compare le hash bcrypt, émet un JWT signé en cas de succès. Même erreur pour mauvais e-mail et mauvais mot de passe (pas d'énumération de comptes).- Middleware sur chaque route protégée vérifiant le JWT côté serveur ; le frontend l'attache automatiquement.
- Propriété au niveau ligne dans les requêtes —
WHERE user_id = $1à partir du token vérifié, pour qu'un ID changé dans l'URL ne puisse pas lire les lignes de quelqu'un d'autre. - Rôles quand le prompt en demande (« l'admin peut gérer les produits ») — une colonne
rolevérifiée dans le middleware, des endpoints réservés à l'admin et une UI conditionnelle assortie.
À côté de l'auth, les défauts de sécurité non négociables : requêtes paramétrées partout (pas de SQL concaténé en chaînes), validation d'entrée côté serveur sur chaque endpoint, CORS restreint à l'origine de l'appli et rate limiting sur les endpoints d'auth. Les patterns sont bons ; relis avant le lancement les règles spécifiques de ton appli sur « qui peut voir les données de qui ».
6 prompts complets à copier-coller pour des applis full-stack
Chacun est complet et sollicite délibérément la génération de backend — comptes, relations, rôles, agrégation. Colle tel quel.
1. Gestionnaire de tâches SaaS avec équipes :
Construis une appli de gestion de tâches nommée Taskframe où les utilisateurs s'inscrivent, créent des projets et ajoutent des tâches avec titre, description, priorité (basse/moyenne/haute), date d'échéance et statut (ouverte/en cours/faite). Les utilisateurs peuvent inviter des coéquipiers à un projet par e-mail ; les membres voient les projets partagés, mais seul le propriétaire du projet peut le supprimer ou retirer des membres. Vues : un tableau groupé par statut avec glisser-déposer entre colonnes, et une vue liste avec tri et filtres. Le dashboard montre mes tâches ouvertes tous projets confondus, triées par échéance, les en-retard en rouge. UI claire et épurée, accent indigo.
2. Boutique e-commerce avec panneau d'admin :
Crée une boutique en ligne de céramique artisanale nommée Kiln & Co. Les clients parcourent une grille de produits avec filtres par catégorie, consultent des pages de détail, ajoutent au panier et passent commande (formulaire d'adresse de livraison + paiement fictif), créant une commande avec historique sauvegardé dans leur compte. Rôle admin : espace /admin séparé avec gestion des produits (créer, modifier, archiver des produits avec nom, prix, stock, catégorie, description), liste des commandes avec mises à jour de statut (en attente/expédiée/livrée) et un récapitulatif du chiffre d'affaires par mois. Le stock décrémente à la commande ; les produits à stock nul affichent épuisé et ne peuvent pas être commandés. Design chaleureux et minimal, accent terracotta.
3. Plateforme de réservation :
Construis une appli de réservation pour un studio de yoga. Public : planning des cours de la semaine (nom, professeur, heure, places restantes), inscription et connexion. Les membres réservent une place dans un cours — capacité imposée côté serveur pour qu'un cours complet refuse d'autres réservations — et peuvent annuler jusqu'à 2 heures avant le début. La page mes réservations montre les cours à venir et passés. Rôle staff : créer et modifier les cours (nom, professeur, jour, heure, capacité), voir les listes par cours et pointer les présences. Empêche la double réservation du même membre dans le même cours. Design apaisant sauge et crème.
4. Board de feedback client :
Crée un board de feedback public façon outil minimal de roadmap produit. Toute personne connectée peut soumettre une idée (titre, description, catégorie) et upvoter les autres — un vote par utilisateur et par idée, togglable. Les idées se trient par votes ou par récence ; chacune a un fil de commentaires. Rôle admin : changer le statut d'une idée (à l'étude/planifiée/en cours/livrée), épingler des idées et supprimer le spam. La page publique de roadmap groupe les idées par statut en colonnes. Les changements de statut apparaissent dans un fil d'activité sur l'idée. Thème sombre, accent bleu électrique.
5. Appli de facturation :
Construis une appli de facturation pour freelances. Les utilisateurs gèrent des clients (société, nom du contact, e-mail, adresse) et créent des factures : client, lignes (description, quantité, prix unitaire), taux de taxe, date d'échéance et un numéro de facture séquentiel auto-généré par utilisateur. Statuts de facture : brouillon, envoyée, payée, en retard — le retard est calculé automatiquement depuis la date d'échéance. Dashboard : encours total, payé ce mois-ci, nombre de retards et un diagramme en barres du chiffre d'affaires sur 6 mois. Page de facture publique en lecture seule via un lien partageable avec une mise en page adaptée à l'impression. Design professionnel ardoise et blanc.
6. Plateforme communautaire de recettes :
Crée une plateforme communautaire de partage de recettes. Les utilisateurs s'inscrivent, publient des recettes (titre, placeholder photo, liste d'ingrédients, étapes numérotées, temps de cuisson, difficulté, tags) et ne modifient ou suppriment que les leurs. Tout le monde navigue par tag ou par recherche plein texte sur les titres et les ingrédients ; chaque recette a des notes en étoiles (une par utilisateur, modifiable) triées par note moyenne, plus des commentaires. Les profils utilisateurs montrent leurs recettes et leurs favoris enregistrés. Page d'accueil : mieux notées cette semaine et plus récentes. Le rôle modérateur peut retirer recettes et commentaires. Design frais vert et crème avec titres en serif.
Le pattern à lire : nomme les entités et leurs champs, dis qui peut faire quoi (« seul le propriétaire peut supprimer »), et mentionne toute règle qui doit tenir (« capacité imposée côté serveur », « un vote par utilisateur »). Ces phrases deviennent des clés étrangères, du middleware et des contraintes.
Comment fonctionnent le déploiement et les aperçus pour les applis full-stack ?
Pendant la génération, le frontend tourne dans une microVM d'aperçu en direct avec hot reload, déjà en train de parler à la vraie API générée — l'inscription que tu testes dans l'aperçu écrit de vraies lignes que tu vois immédiatement dans le navigateur de tables du panneau Backend, ou que tu requêtes en SQL brut. Le déploiement expédie le frontend sur l'edge de Cloudflare et le backend + PostgreSQL sur l'infrastructure de VULK — un clic, URL en production, domaines personnalisés pris en charge. Les déploiements backend + PostgreSQL sont inclus à partir de l'offre Builder (19,99 $/mois) ; l'itération après déploiement reste la même boucle de prompts de suivi, avec les changements de schéma gérés comme des migrations plutôt que des reconstructions destructrices de données.
Que peut-on exporter d'une appli full-stack ?
La question à poser à toute plateforme avant d'avoir 10 000 utilisateurs. Voici la réponse de VULK, précisément :
Ce qui s'exporte proprement :
- La source frontend complète — téléchargement ZIP ou push GitHub ; un projet standard React + Vite + TypeScript sans dépendances propriétaires.
- Ton schéma complet — le
schema.sqlest livré dans l'export de la source. - Toutes tes données — export CSV par table depuis le panneau Backend (la table entière, pas seulement la page visible), plus l'accès SQL brut via le query runner.
Pour situer comment le reste du marché répond à la même question : Lovable/Bolt ont la portabilité des données la plus propre — le projet Supabase est à toi, pg_dump et c'est parti (la logique backend en edge functions et politiques RLS doit quand même migrer). Replit donne l'accès complet au code ; c'est ta VM. Base44 n'a aucun export de backend. Les outils frontend-only esquivent la question en n'ayant jamais eu tes données. Quel que soit l'outil choisi : teste le chemin d'export la semaine un, pas le mois douze.
Questions fréquentes
Quelle est la différence entre un vrai backend et des données factices dans les builders IA ?
Quatre tests : les données survivent aux redéploiements ; la connexion vérifie les identifiants côté serveur et émet une session ; changer un ID dans une requête ne peut pas lire les lignes d'un autre utilisateur ; et tu peux exécuter du SQL sur ta base. VULK, Replit, Databutton et les outils délégués à Supabase (Lovable, Bolt) les passent. Les démos où les « données » vivent dans un fichier JSON ou en localStorage n'en passent aucun — ce sont des prototypes en costume de produit.
Dois-je connaître SQL pour construire une appli full-stack avec l'IA ?
Non — tu décris des entités et des règles en langage courant, et le schéma, les index et les contraintes sont générés (62 % des applis VULK en reçoivent un ; données de la plateforme, juillet 2026). Mais le SQL n'est jamais caché : le query runner du panneau Backend accepte du SQL brut et le schéma est livré dans ton export — le jour où tu veux apprendre ou vérifier, tout est inspectable. Cette inspectabilité est la différence pratique entre « base de données no-code » et « base de données générée ».
Le code backend généré par IA est-il assez sûr pour la production ?
Les patterns générés sont les bons — hachage bcrypt dans password_hash, requêtes paramétrées, middleware JWT, requêtes limitées à l'utilisateur, auth avec rate limiting, CORS. Relis-le avant le lancement — surtout les règles d'autorisation propres à ton appli (qui exactement peut lire et modifier les lignes de qui). Cette relecture est radicalement plus simple quand le backend est un schéma lisible + des endpoints REST plutôt qu'une magie de plateforme opaque. L'autorisation mal configurée est aussi le premier mode d'échec du monde des backends délégués (RLS de Supabase) — aucune architecture ne te dispense d'y réfléchir.
Puis-je connecter mon propre Supabase ou un backend externe à la place ?
Sur VULK, oui — à partir de l'offre Pro, les intégrations incluent Supabase (plus Railway, Paddle, AWS S3 et d'autres) avec stockage chiffré des identifiants et variables d'environnement par projet. Par défaut, la génération utilise le backend propre à VULK et ajoute Supabase quand tu le demandes, parce que le backend généré sans configuration est l'expérience cœur.
Combien coûte le fonctionnement d'une appli full-stack générée par IA ?
VULK : Builder 19,99 $/mois — ce qui inclut le backend déployé + PostgreSQL, c'est-à-dire ton hébergement, plus la sync GitHub et les domaines personnalisés — Pro 39,99 $/mois (ajoute tous les modèles, la vidéo IA et la 3D avec modèles GLB), Max 199 $/mois. Stacks comparables ailleurs : Lovable/Bolt à partir de 25 $/mois plus Supabase au-delà de son offre gratuite ; Databutton 20 $/mois (à crédits) ; Base44 à partir de 20 $/mois (les boucles de crédits peuvent gonfler la note). Voie traditionnelle : un MVP full-stack en freelance avec auth et base de données démarre typiquement autour de 10 000 $. Tarifs vérifiés le 17 juillet 2026.
Qu'arrive-t-il à mon appli si j'annule mon abonnement ?
Ton code et tes données sont exportables à tout moment — frontend en ZIP/GitHub, schema.sql, CSV par table — annuler ne bloque donc jamais les actifs (exporte avant d'annuler). Un conseil de prévoyance qui vaut pour chaque plateforme de ce guide, la nôtre incluse.
Décris l'appli — comptes, données et tout le reste — et regarde le formulaire de connexion fonctionner pour de vrai : vulk.dev.